
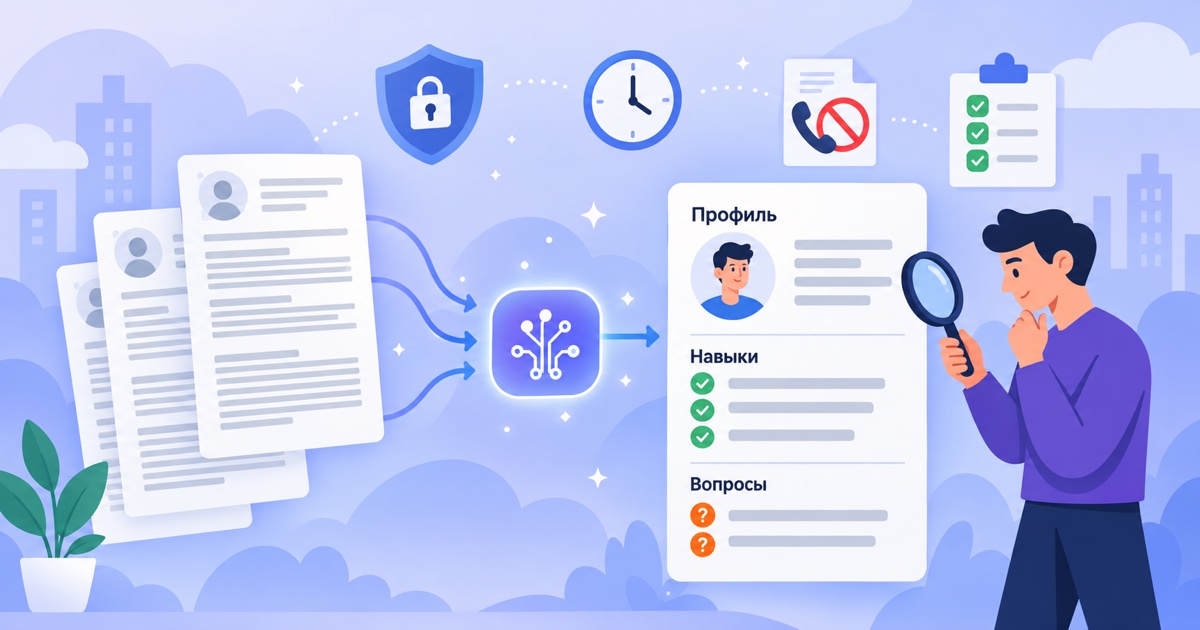
На вакансию пришло сорок откликов, и к десятому резюме глаза уже читают по диагонали: должность, последняя компания, город, дальше. К тридцатому вы пропускаете человека, который подошёл бы, потому что его опыт описан не теми словами. Нейросеть для разбора резюме обещает снять именно эту работу, но обещания вендоров редко объясняют, что происходит внутри. Разберём по шагам, что языковая модель делает с текстом резюме. Какие задачи решает хорошо, а где ошибается предсказуемо. Что говорит закон про автоматический отказ. И как проверить любой ИИ-инструмент на своих резюме за один вечер.
Что нейросеть на самом деле делает с резюме
За словами «ИИ разбирает резюме» на рынке стоят три разные технологии. Они дают разный результат, и путать их дорого: от этого зависит, за что вы платите и кому потом объяснять отказ.
| Технология | Что делает | Где ошибается |
|---|---|---|
| Парсер полей | Вытаскивает из документа должность, компании, даты, город, зарплату | Нестандартная вёрстка, резюме в картинке, две колонки |
| Поиск по ключевым словам | Считает совпадения слов из вакансии со словами в резюме, ранжирует | Синонимы («продажи B2B» и «работа с корпоративными клиентами» для него разные вещи), резюме, набитые ключами под фильтр |
| Языковая модель | Читает текст как человек и пересказывает: чем занимался, что умеет, чего не хватает | Домысливает, слабо понимает редкие специальности, трактует перерывы как минус |
Первые две работают в системах подбора лет пятнадцать. Новое здесь только третье: языковая модель понимает смысл, а не буквы. Ей всё равно, написал кандидат «вёл переговоры с сетями» или «key account management», она сведёт это к одному навыку. Зато у неё появилась способность, которой у парсера не было никогда: уверенно написать то, чего в резюме нет.
Зрелые системы совмещают все три. Формальные поля берёт парсер, потому что дату ошибаться нельзя. Смысл читает модель. А поиск по ключам остаётся для быстрой фильтрации базы, когда нужно найти всех, кто упоминал «1С:ЗУП». Если вендор продаёт «нейросеть для разбора резюме» и не уточняет, за что именно она отвечает, спросите.
Как работает нейросеть для разбора резюме: путь от загрузки до карточки
Разберём процесс на примере того, как он устроен в Treex. У других продуктов детали отличаются, но последовательность похожая, и по ней удобно задавать вендору вопросы.
Шаг 1. Из текста вырезают контакты. Система удаляет имя, телефон, почту и ссылки на профили до того, как текст уходит в модель. Делает это обычный код с регулярными выражениями, а не «умный» алгоритм: то, что нельзя доверить вероятностной модели, ей и не доверяют. Для службы безопасности это главный пункт, о нём ниже.
Шаг 2. Парсер заполняет формальные поля. Должность, компании, даты, город и зарплатные ожидания парсер берёт из структуры документа и кладёт в карточку. Там, где ошибка стоит дорого и проверяется глазами, вероятностный ответ не нужен.
Шаг 3. Модель читает обезличенный текст. В нейросеть уходит опыт, навыки, образование, описание проектов. На выходе краткий профиль: три-четыре предложения о том, чем человек занимался, и список навыков, которые в тексте подтверждены делом, а не просто перечислены через запятую.
Шаг 4. Карточка получает пометку «разобрано ИИ». Бейдж говорит рекрутеру: текст в профиле написала машина, его стоит проверить. Как только человек правит поле руками, пометка исчезает. Это простая, но важная механика: вы всегда знаете, что в базе проверено, а что нет.
Разбор одного резюме занимает секунды против пяти минут чтения. Но выигрыш не только во времени. Результат одинаково подробный для первого резюме за день и для сорокового, когда внимание живого человека уже не то. Нейросеть не устаёт, и в этом её главное преимущество перед рекрутером, а не в «интеллекте».
Что умеет ИИ в разборе резюме: пять задач
Языковая модель хорошо делает то, что сводится к формуле «прочитай текст и переложи в структуру». Вот пять задач из этой категории, на которых нейросеть для разбора резюме действительно экономит время.
Краткий профиль вместо трёх страниц
Модель сжимает резюме на три страницы до абзаца: сфера, уровень, чем занимался последние годы, куда двигался. Это не замена чтению, а фильтр перед ним: из двадцати профилей вы открываете целиком пять, которые стоят внимания.
Подтверждённые навыки против заявленных
В разделе «Навыки» кандидат пишет двадцать пунктов. Модель сверяет их с описанием опыта и разделяет: «Python» подтверждён тремя проектами, «управление командой» упомянуто один раз без подробностей. Это самый полезный вывод для интервью: вы знаете, о чём спрашивать.
Пробелы и нестыковки
Модель замечает, чего в резюме не хватает: нет результатов работы, нет причин перехода, нет упоминания инструментов, которые обязательны для вакансии. Не как приговор, а как список вопросов кандидату.
Оценка совпадения с вакансией
Если модели дать и резюме, и текст вакансии, она объяснит, где человек подходит, где нет и почему. Ключевое слово — «объяснит». Цифра «78%» без обоснования бесполезна. А три предложения о том, что кандидат закрывает четыре требования из пяти и не работал с нужной отраслью, помогают решить. Качество этого ответа упирается в текст вакансии: из требований «коммуникабельность и стрессоустойчивость» модель не выведет ничего, из блока с задачами и измеримыми требованиями — выведет. Как собрать такой текст, разобрано в гайде как написать вакансию.
Вопросы к интервью
По найденным пробелам модель формулирует вопросы: «Уточните, какой была ваша роль в проекте X: вы описали результат команды, а не свой». Рекрутер приходит на интервью подготовленным, даже если открыл резюме за пять минут до созвона.
Всё, что дальше по списку у вендоров: «автоматический отбор», «ранжирование по пригодности», «ИИ сам приглашает лучших», выходит за рамки этой формулы. Там модель уже принимает решение, а не готовит материал. Почему это плохая идея, разберём в двух следующих разделах.
Где нейросеть ошибается: четыре предсказуемых сбоя
Языковая модель ошибается не случайно. Сбои повторяются на одних и тех же типах резюме, и это хорошая новость: зная их, вы понимаете, какие карточки проверять внимательнее.
Нестандартные биографии. Смена профессии, свой бизнес, фриланс, работа на себя. Всё, что не укладывается в привычную цепочку «должность → компания → даты», модель описывает беднее, чем есть. Человек, который пять лет вёл собственное кафе, а теперь идёт в закупки, в кратком профиле выглядит как «предприниматель без релевантного опыта». Хотя закупки он вёл сам все пять лет.
Перерывы в стаже. Декрет, уход за родственником, лечение, переезд. Для модели это пробел в датах, и любая автоматика склонна трактовать пробел как минус. Живой рекрутер в этом месте задаёт вопрос, алгоритм молча понижает оценку. Если система ранжирует кандидатов сама, именно эти люди уедут в конец списка.
Редкие специальности и жаргон. Чем уже область, тем выше шанс, что модель не распознает ключевой навык или примет за навык название внутренней системы работодателя. В резюме технолога молочного производства или инженера КИПиА она пропустит то, что для отраслевого специалиста очевидно.
Домысливание. Языковая модель устроена так, что всегда продолжает текст. Если в резюме сказано «работал в банке», а вакансия про кредитование, модель может написать «опыт в кредитовании», хотя человек сидел в IT-поддержке. Это не баг, который починят в следующей версии, а свойство технологии. Отсюда правило: каждое утверждение модели о кандидате вы должны найти в тексте резюме, и в хорошей системе это делается в один клик.
Есть и пятый сбой, обратный: кандидаты научились писать резюме под ИИ. Инструкции «как пройти ИИ-скрининг» выходят на vc.ru регулярно, а сервисы, которые набивают резюме ключами из вакансии, доступны любому. Поиск по ключевым словам на такое ловится сразу. Языковая модель держится лучше. Но раздутый список навыков без подтверждения в опыте она тоже иногда принимает за чистую монету.
Почему нейросеть не должна отказывать кандидатам
Самый частый вопрос от руководителя: «А может ИИ сразу отсеивать неподходящих?» Технически может. Не стоит, и на то есть две причины: закон и арифметика.
Закон. Статья 16 федерального закона 152-ФЗ запрещает принимать решения, которые затрагивают права человека, на основании исключительно автоматизированной обработки его персональных данных. Исключение одно: письменное согласие самого человека. Отказ в приёме на работу такие права затрагивает. Значит, если алгоритм сам отклонил кандидата и никто из людей на резюме не смотрел, вы нарушили закон, даже если модель была права.
Добавьте сюда статью 64 Трудового кодекса: по письменному требованию кандидата вы обязаны в течение семи рабочих дней сообщить причину отказа. Написать «нейросеть поставила 43 балла» нельзя, а объяснить, почему модель поставила именно столько, обычно не может даже вендор.
Арифметика. Массовый подбор на сто одинаковых позиций переживёт ошибку алгоритма: потерялся один подходящий из тысячи, придут ещё. Компания, которая нанимает пять человек в год, такого запаса не имеет. Автоматический отсев отбрасывает именно неочевидных кандидатов, а неочевидные и есть те, ради кого небольшая команда ведёт базу кандидатов, а не берёт первого из выдачи.
Отсюда рабочая позиция: ИИ-помощник, а не ИИ-рекрутер. Модель сжимает, структурирует, подсвечивает пробелы. Решение принимает человек, и это не осторожность ради осторожности, а единственная схема, при которой вы можете ответить кандидату на вопрос «почему».
Заметьте, как этот критерий делит рынок. В обзоре AI-рекрутёров России половина продуктов строится вокруг автопилота: сам переписывается, сам проводит первичное интервью, сам отсеивает. Это другой класс продукта и другая степень доверия к автоматике, и ему нужен поток, на котором ошибки статистически незаметны.
Персональные данные: что можно отправлять в модель
Резюме — это персональные данные, а языковая модель — сторонняя обработка. По части 3 статьи 6 Федерального закона № 152-ФЗ «О персональных данных» поручить обработку другому лицу можно только с согласия субъекта. Ответственность перед кандидатом при этом остаётся на вас, а не на поставщике модели. Первый вопрос службы безопасности будет именно об этом, и лучше иметь ответ до внедрения.
Три вещи, которые стоит выяснить у любого инструмента:
- Что уходит в модель. Резюме целиком, с именем и телефоном, или обезличенный текст. Правильный ответ: контакты вырезаются до отправки, и не самой моделью, а детерминированным кодом.
- Где физически работает модель. Рекрутер копирует резюме в ChatGPT — персональные данные уезжают на серверы за пределами России. Это нарушение требования о локализации из части 5 статьи 18 того же закона, без вариантов. Российское облако снимает вопрос.
- Можно ли выключить. Есть ли переключатель, который гасит ИИ целиком, а остальная система работает как прежде. Если нет, согласование со службой безопасности превратится в согласование всей закупки.
В Treex все три вопроса решены так: в модель уходит обезличенный текст, обработка идёт в российском облаке, ИИ отключается одним тумблером в настройках компании. Подробнее о том, что именно происходит с данными, на странице ИИ для рекрутера.
Разбор резюме в ChatGPT или GigaChat: когда это работает
Рекрутеры часто начинают с ручного способа: копируют резюме в чат с нейросетью и просят разобрать. Для десятка резюме в месяц этого хватает, и промпт стоит держать под рукой.
Текст промпта, который можно скопировать целиком:
Ты помощник рекрутера. Ниже текст резюме и текст вакансии.
Сделай четыре вещи.

1. Краткий профиль кандидата в 3-4 предложениях: сфера, уровень,
   чем занимался последние три года.
2. Навыки, подтверждённые описанием опыта, отдельно от навыков,
   которые только перечислены.
3. Чего в резюме не хватает относительно требований вакансии.
4. Пять вопросов для интервью по найденным пробелам.

Не додумывай факты. Если чего-то нет в тексте, напиши
«в резюме не указано».

Резюме: [текст без имени и контактов]
Вакансия: [текст]
Фраза «не додумывай факты» не гарантия, но заметно снижает домысливание. И обратите внимание на скобки: контакты из резюме перед вставкой нужно удалить руками, иначе вы отправляете персональные данные на сторонний сервис.
У ручного способа три ограничения. Первое: результат живёт в чате, а не в карточке кандидата, и через неделю его не найти. Второе: каждое резюме нужно скопировать, очистить и вставить, на потоке это дольше, чем прочитать. Третье: у ChatGPT серверы за границей. У российских моделей ситуация лучше, но копирование резюме в чужой сервис всё равно не то, о чём хочется рассказывать проверяющему.
Когда объём переваливает за несколько десятков резюме в месяц, нейросеть для разбора резюме имеет смысл встраивать в систему, где живёт база. Какие инструменты для этого есть и чем отличаются, мы разбирали в статье об AI-инструментах для рекрутера.
Как проверить нейросеть для разбора резюме на своих файлах за вечер
Демо-данные вендора всегда разбираются идеально. Проверять нейросеть для разбора резюме нужно на своих кандидатах, и на это уходит один вечер.
- Возьмите пять резюме, решение по которым вы помните. Два сильных кандидата, два слабых, один спорный. Так сразу видно, совпадает ли краткий профиль с вашим впечатлением.
- Добавьте одно резюме с перерывом в стаже или сменой профессии. Посмотрите, как модель его описывает: задаёт вопрос или тихо обесценивает.
- Проверьте каждое утверждение модели по тексту. Найдите хотя бы один навык из вывода в резюме. Не нашли — это домысливание, и вы теперь знаете, как часто оно случается.
- Дайте модели вакансию и спросите про совпадение. Оцените не цифру, а объяснение: понятно ли, почему кандидат подходит или нет.
- Посмотрите, что происходит с контактами и где хранится результат. Остался ли разбор в карточке, видно ли, что его писала машина, можно ли поправить руками.
Если после пятого пункта результат совпал с вашим впечатлением в четырёх случаях из пяти, а пятый вы поняли, откуда взялся, инструмент работает. Если модель уверенно расписала опыт, которого в резюме не было, и вы не можете этого проверить, дальше смотреть не нужно.
Отдельный совет про лимиты. Считайте, во что обойдётся ваш реальный поток: сколько резюме в месяц вы разбираете и сколько ИИ-действий это съест. «Безлимит» в ИИ-продуктах почти всегда означает лимит, который вам не показали, потому что каждое обращение к модели стоит вендору денег.
Итог: нейросеть читает, человек решает
Нейросеть для разбора резюме хорошо делает одно: читает текст и превращает его в структуру. Краткий профиль, подтверждённые навыки, пробелы, вопросы к интервью, объяснение совпадения с вакансией. На потоке в сорок откликов это час-полтора однообразной работы, и модель сжимает её до просмотра сорока абзацев.
Чего она не должна делать: отказывать. По закону автоматический отказ без человека запрещён, по здравому смыслу он отсеивает именно тех неочевидных кандидатов, ради которых небольшая компания ведёт базу. Модель ошибается предсказуемо: нестандартные биографии, перерывы, редкие специальности, домысливание. Зная это, вы знаете, какие карточки проверять.
И проверяйте инструмент на своих резюме, а не на демо. Вечер и пять кандидатов, решение по которым вы помните, скажут о нейросети больше любой презентации.
Попробуйте ИИ-разбор на своих резюме
В Treex на бесплатном тарифе 20 ИИ-действий, до 150 кандидатов, воронка и напоминания. Персональные данные в модель не уходят, обработка в России, ИИ отключается одним тумблером. Без карты и созвона с менеджером.


